Exploratory Data Analysis
Two open-ended R analyses: US regional minimum wage trends (1968–2020) and National Park trail exploration with functional programming and statistical inference.
Data
US minimum wage data from 1968–2020, with effective wages adjusted to 2020 dollars. A Region variable was added using US Census Bureau groupings: Northeast, Midwest, South, West.
library(tidyverse); library(ggplot2)
min_wage <- read_csv("minimum-wage-data.csv")
enriched_region_list <- read_csv("region_list1.txt", show_col_types = FALSE)
enriched_min_wage    <- full_join(min_wage, enriched_region_list)
Summary Statistics
2010–2020
enriched_min_wage |>
  filter(2010 < Year) |>
  group_by(Region) |>
  summarise(
    mean_effective_wage = mean(Effective.Minimum.Wage.2020.Dollars),
    var_effective_wage  = var(Effective.Minimum.Wage.2020.Dollars)) |>
  slice_max(var_effective_wage, n = 5)
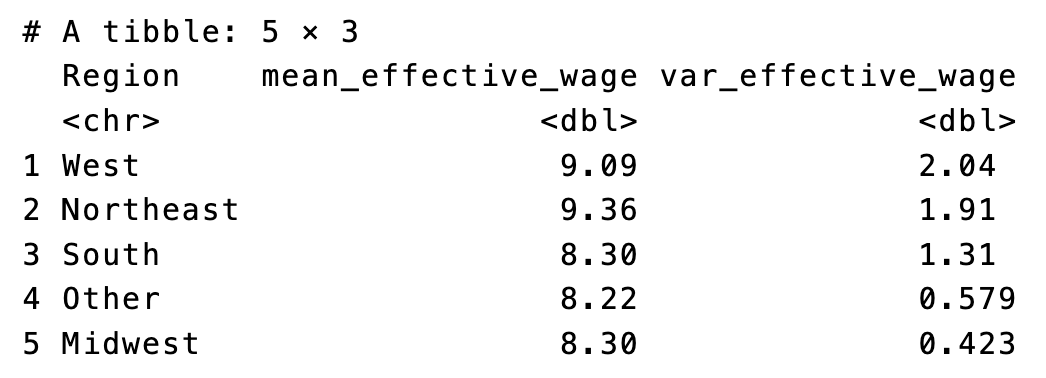
West: highest mean ($9.09) and variance (2.04)
1968–1980
enriched_min_wage |>
  filter(1980 > Year) |>
  group_by(Region) |>
  summarise(
    mean_effective_wage = mean(Effective.Minimum.Wage.2020.Dollars),
    var_effective_wage  = var(Effective.Minimum.Wage.2020.Dollars)) |>
  slice_max(var_effective_wage, n = 5)
Visualizations
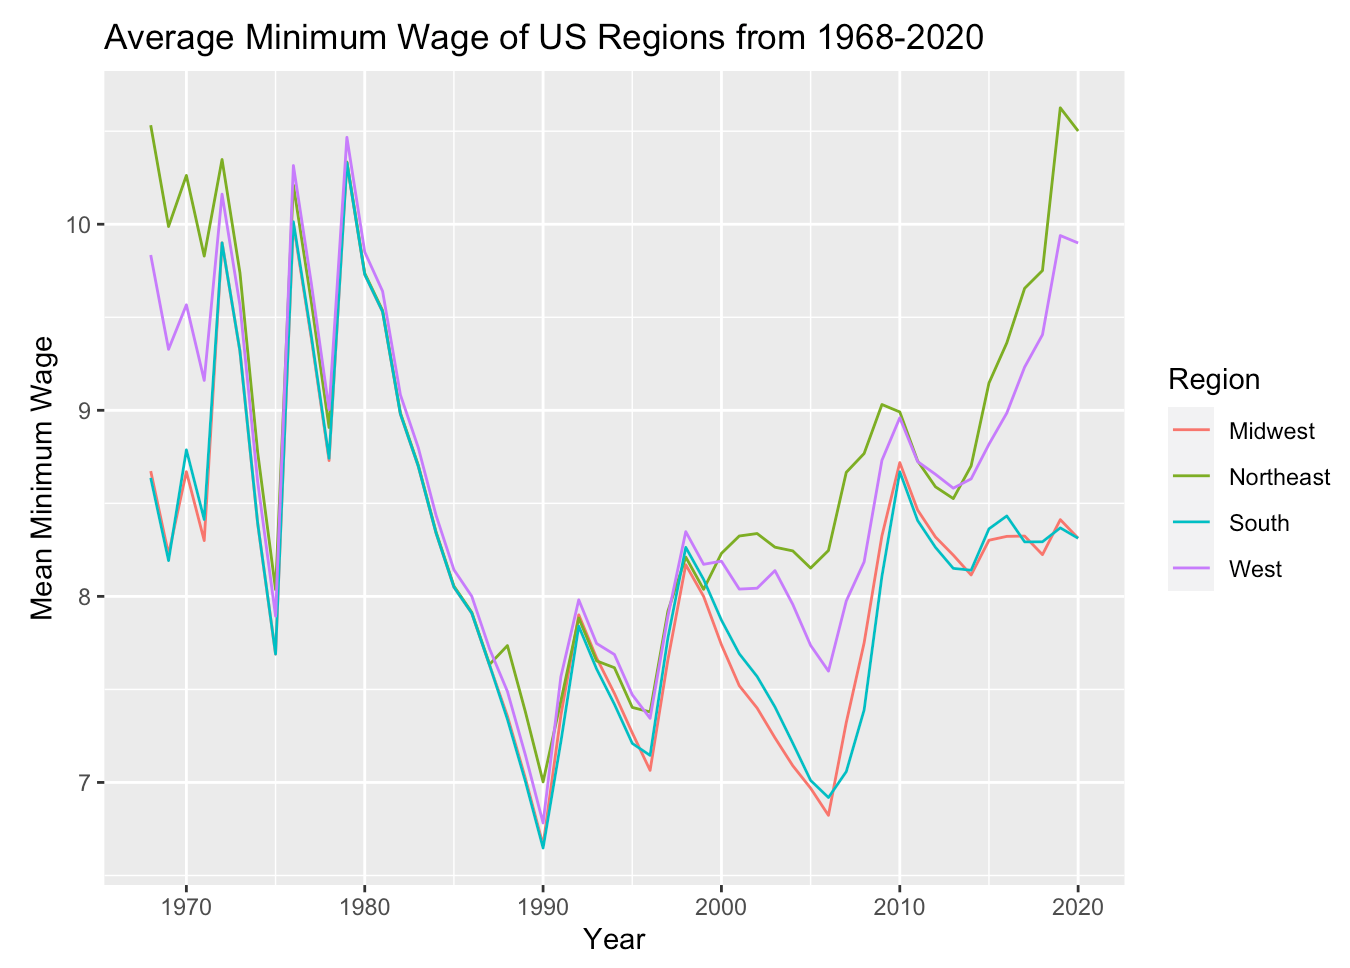
Average Minimum Wage by Region, 1968–2020
enriched_min_wage |>
  filter(Region != "Other") |>
  group_by(Region, Year) |>
  summarise(mean_effective_wage = mean(Effective.Minimum.Wage.2020.Dollars)) |>
  ggplot(aes(x = Year, y = mean_effective_wage, color = Region)) +
  geom_line() +
  labs(y = "Mean Minimum Wage", title = "Average Minimum Wage of US Regions 1968-2020")
Distribution by Region, 2010–2020
enriched_min_wage |>
  filter(Region != "Other", Year > 2009) |>
  ggplot(aes(x = factor(Year), y = Effective.Minimum.Wage.2020.Dollars, color = factor(Region))) +
  geom_boxplot(outlier.shape = NA) +
  guides(color = guide_legend(title = "Region"))
Analysis
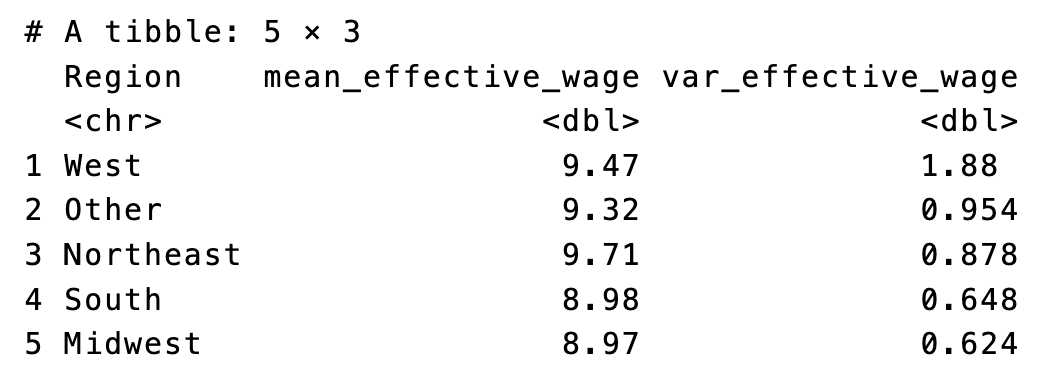
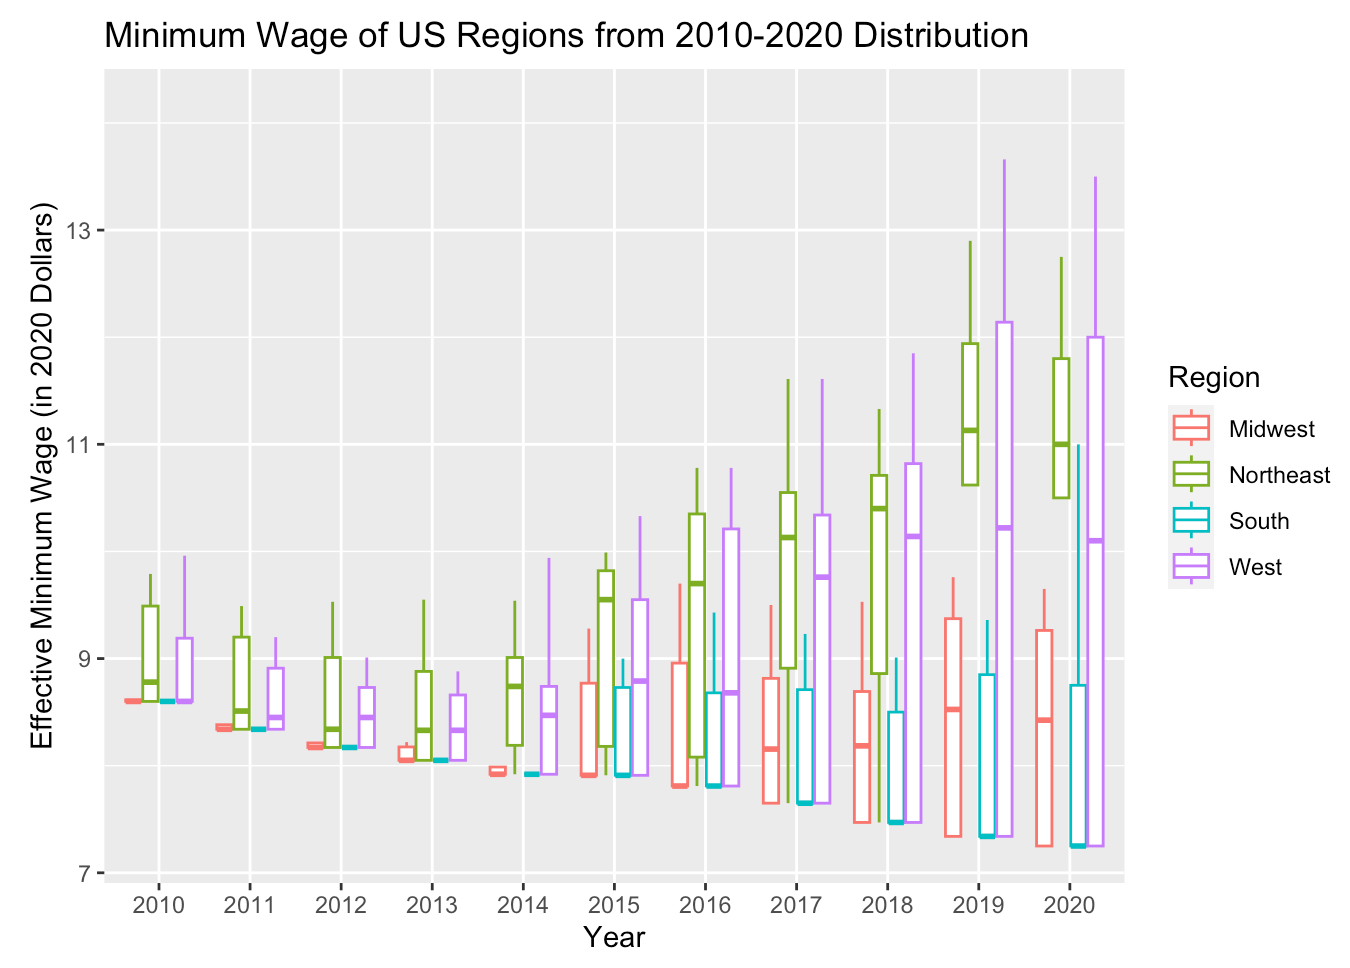
From 1975 to 2000, regional minimum wages converged closely. Since 2000 they have diverged sharply, with the Northeast growing substantially while the South and Midwest lagged. From 2010–2020, year-over-year variance within each region grew steadily, with the West consistently showing the widest distribution, reflecting state-level policy divergence.
Data
All US National Park trails: state, area name, length, elevation gain, difficulty rating, average rating, popularity, visitor usage, and route type.
library(tidyverse); library(purrr)
national_park <- read.csv("national_park_trails.csv")
Exploration
Fourth longest trail in California?
national_park |>
  filter(state_name == "California") |>
  mutate(length_mi = length * 0.000621371) |>
  slice_max(n = 4, order_by = length_mi) |> slice(4) |> select(name, length_mi)
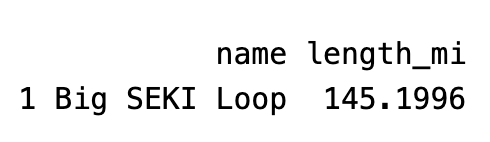
Big SEKI Loop: 145.2 miles
Park with most "easy" trails? (elev < 500m, dist < 5km, difficulty < 4)
national_park |>
  mutate(length_km = length * 0.001) |>
  filter(elevation_gain < 500, difficulty_rating < 4, length_km < 5) |>
  group_by(area_name) |> summarise(easy_trail_num = n()) |>
  slice_max(n = 1, order_by = easy_trail_num)
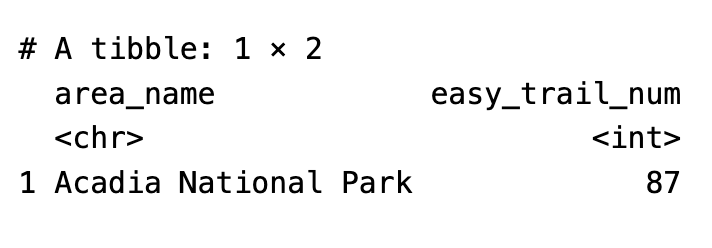
Parks with "Mountain" in name?
national_park |> filter(str_detect(area_name, "Mount|Mt|Mountain")) |> count()
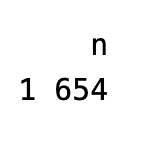
Distribution of trail scores
national_park |>
  pivot_longer(cols = c(avg_rating, difficulty_rating, popularity, visitor_usage),
               names_to = "measure", values_to = "score") |>
  ggplot(aes(x = score)) + geom_density() + facet_wrap(~ measure, scales = 'free')
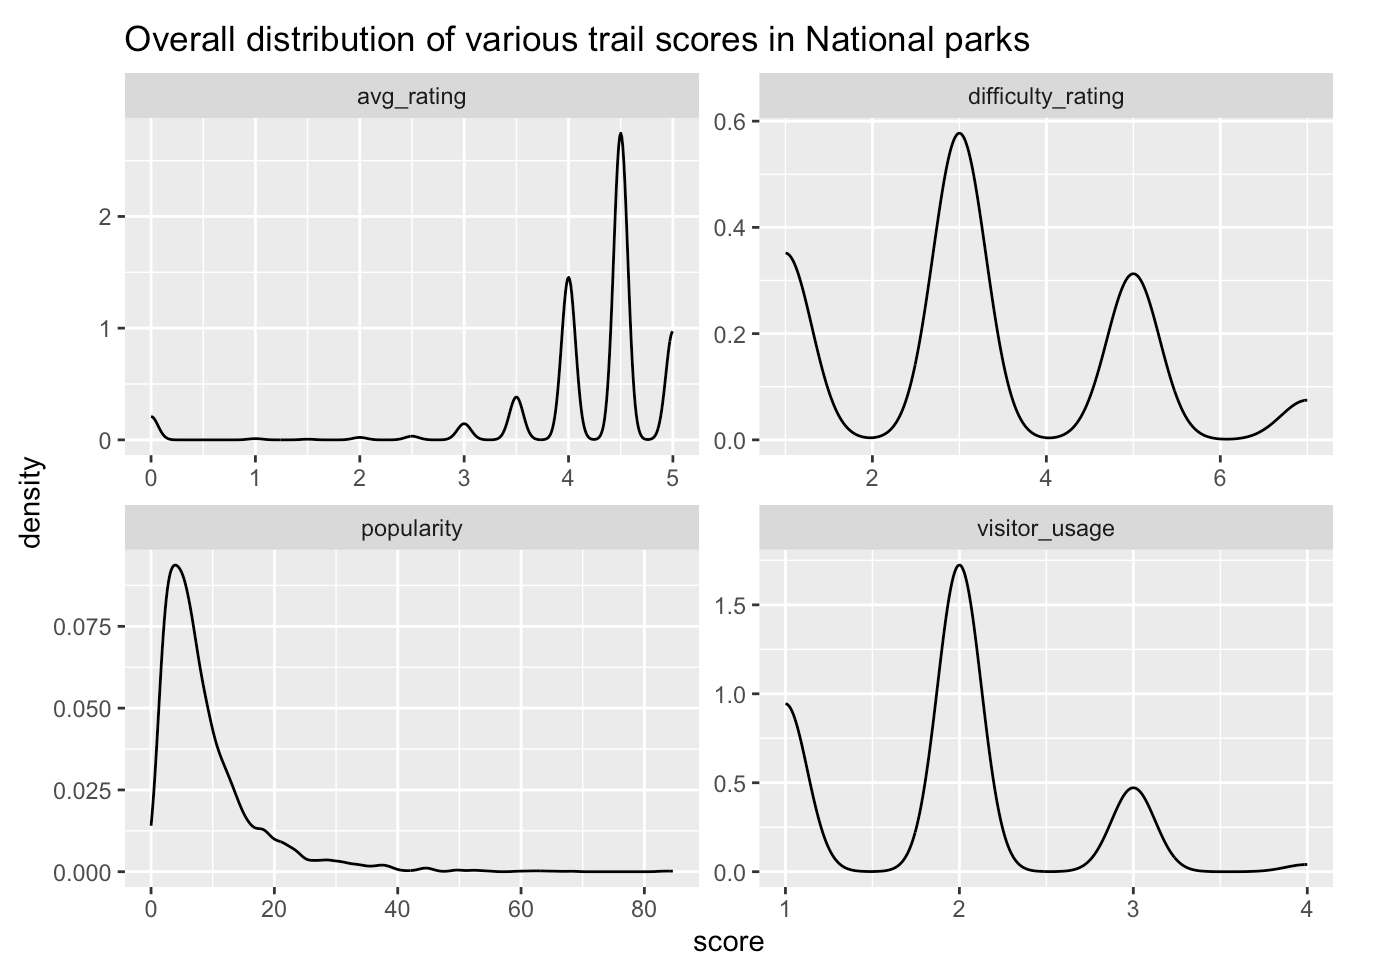
Trail Recommendation Function
recommend_trails <- function(data, park_name, min_elev=0, max_elev=Inf, min_rating=0, trl_type=NULL) {
  result <- data |>
    filter(area_name==park_name, elevation_gain>=min_elev,
           elevation_gain<=max_elev, avg_rating>=min_rating)
  if (!missing(trl_type)) result <- result |> filter(route_type %in% trl_type)
  result |> select(name)
}

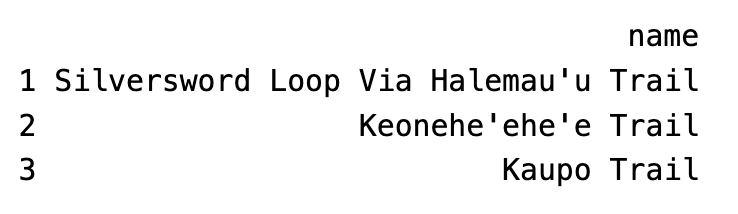
# Test: Haleakala, min 1000m elev, min 4.0 rating
national_park |> recommend_trails("Haleakala National Park", min_elev=1000, min_rating=4)
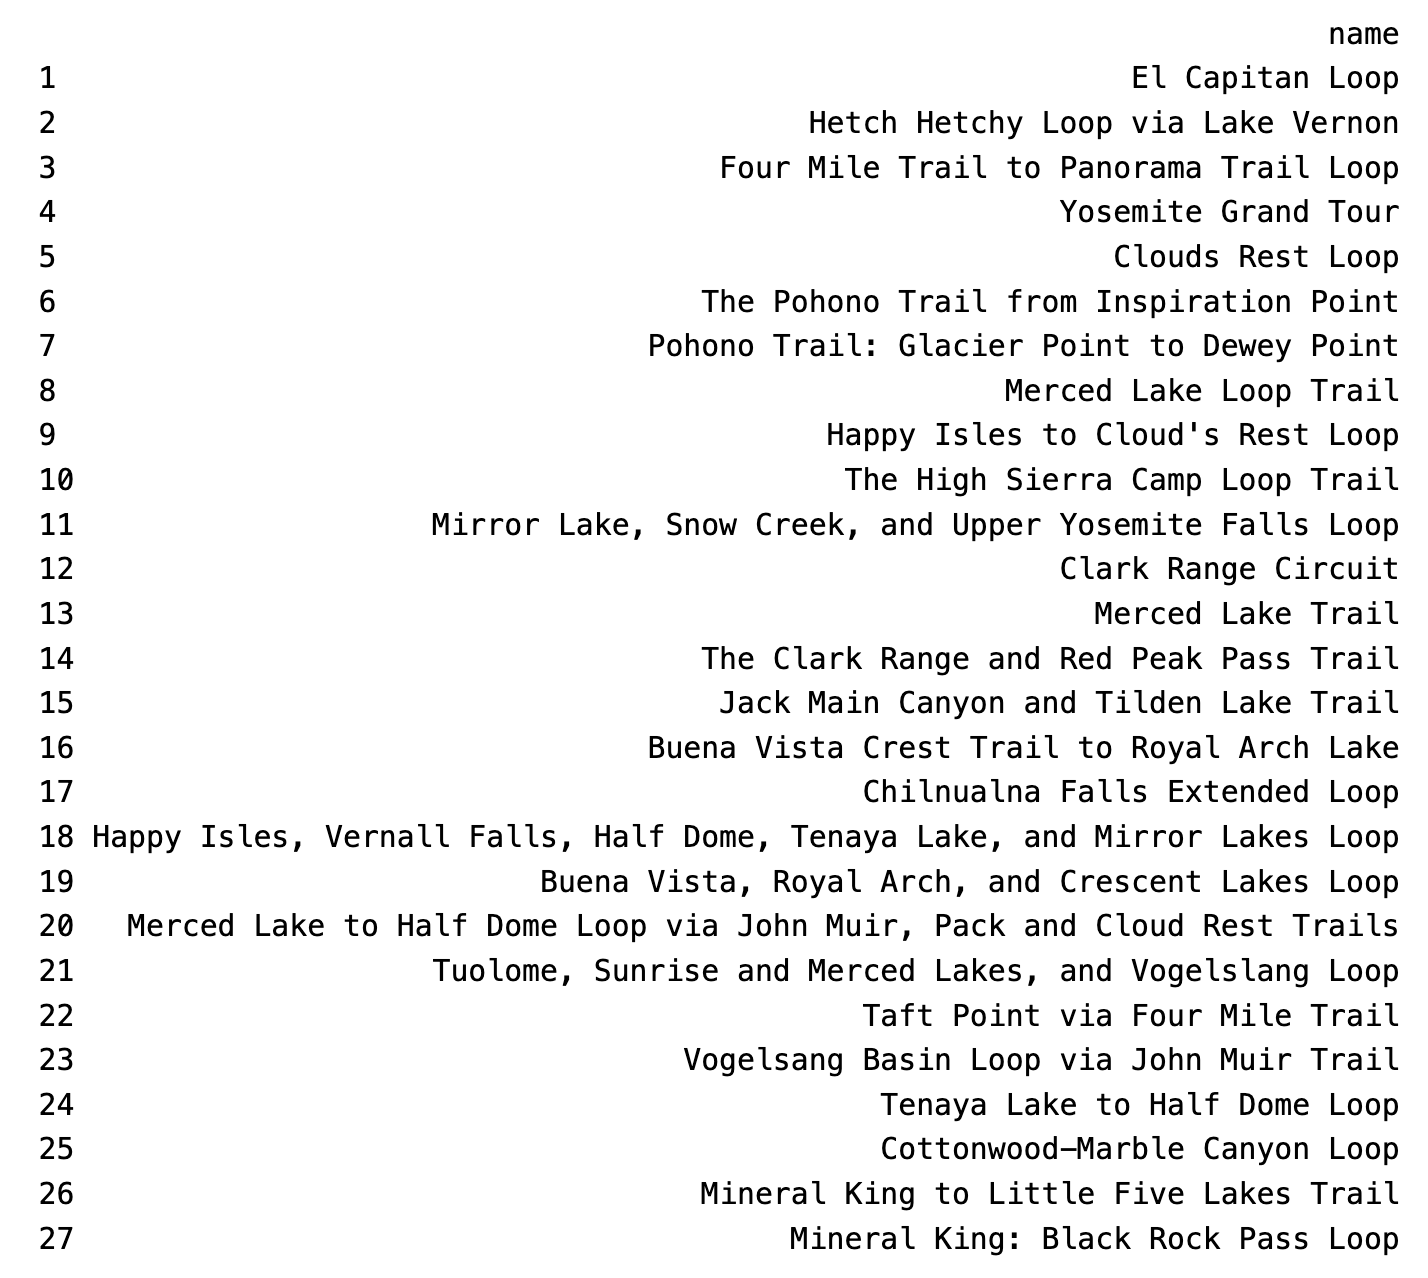
map_dfr across 7 California parks
map_dfr(.x = c("Yosemite National Park", "Joshua Tree National Park",
               "Death Valley National Park", "Pinnacles National Park",
               "Lassen National Park", "Sequoia National Park", "King's Canyon National Park"),
        ~ recommend_trails(national_park, .x, min_elev=1000, max_elev=3000, min_rating=4.5, trl_type="loop"))
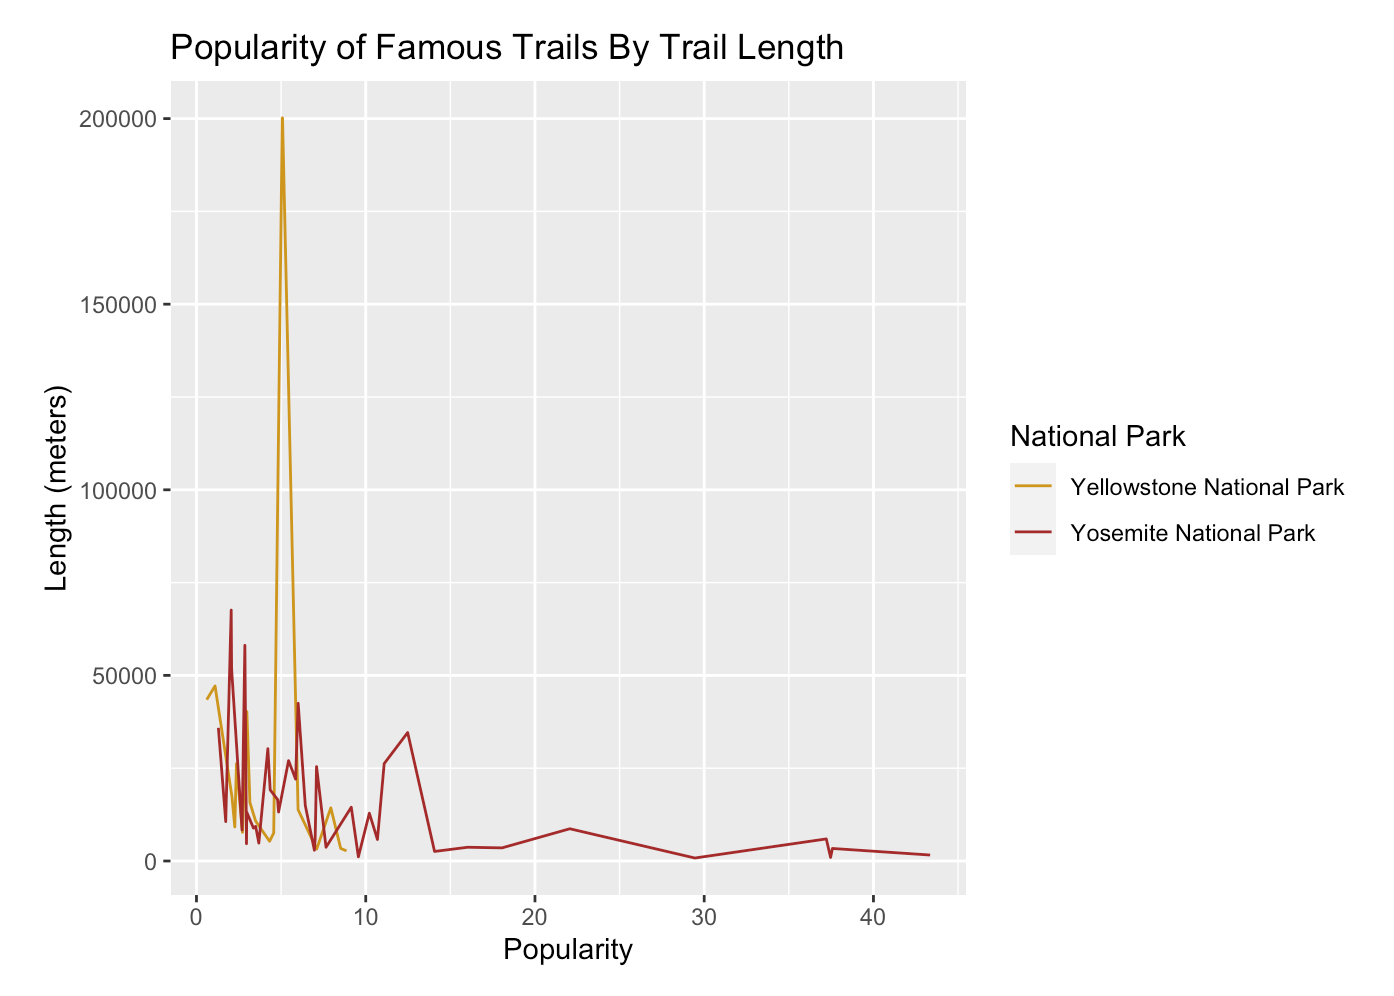
Research Question: Yosemite vs. Yellowstone
Which park has "better" trails, defined by higher average rating and popularity among dog-friendly trails?
national_park |>
  filter(area_name %in% c("Yosemite National Park", "Yellowstone National Park"),
         avg_rating > 3, !str_detect(features, "'dogs-no'")) |>
  ggplot(aes(x=popularity, y=length, color=area_name)) + geom_line() +
  scale_color_manual(values=c("Yosemite National Park"="brown", "Yellowstone National Park"="#CD9600"))
Welch Two-Sample t-test
better_park <- national_park |>
  filter(area_name %in% c("Yosemite National Park", "Yellowstone National Park")) |>
  select(area_name, avg_rating, popularity)
t.test(avg_rating  ~ area_name, data=better_park)  # p > 0.05, not significant
t.test(popularity ~ area_name, data=better_park)  # p < 0.05, Yosemite higher
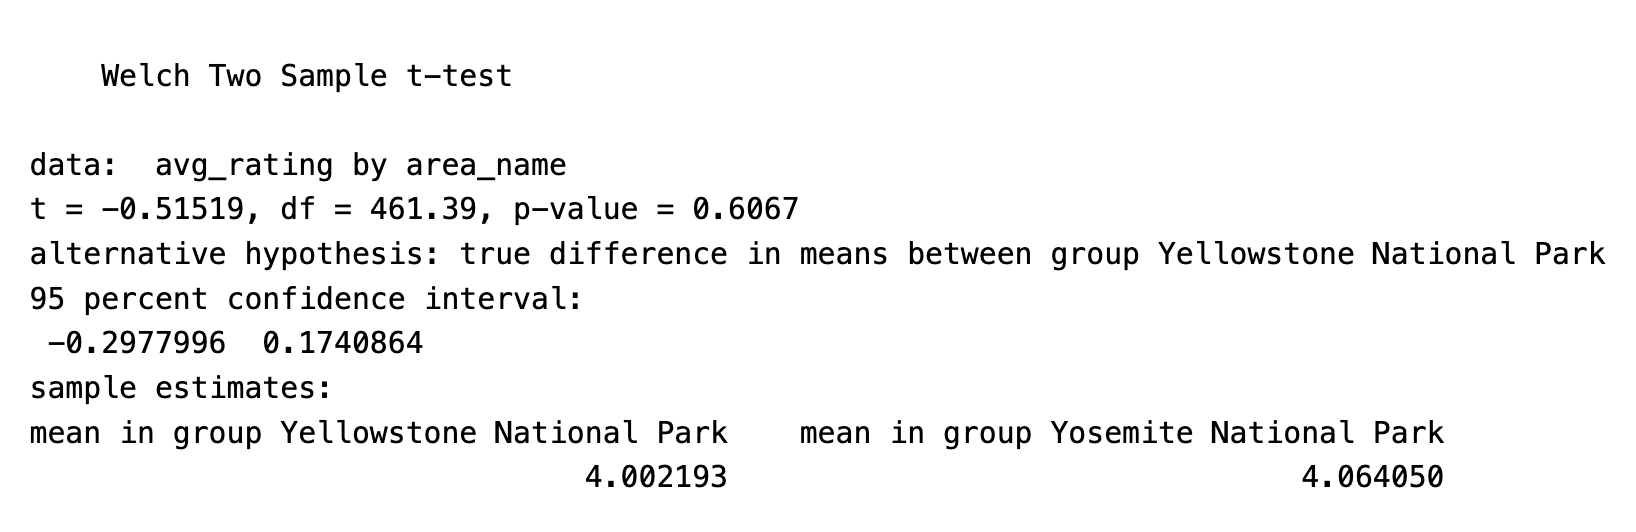
Rating: not significant (p > 0.05)
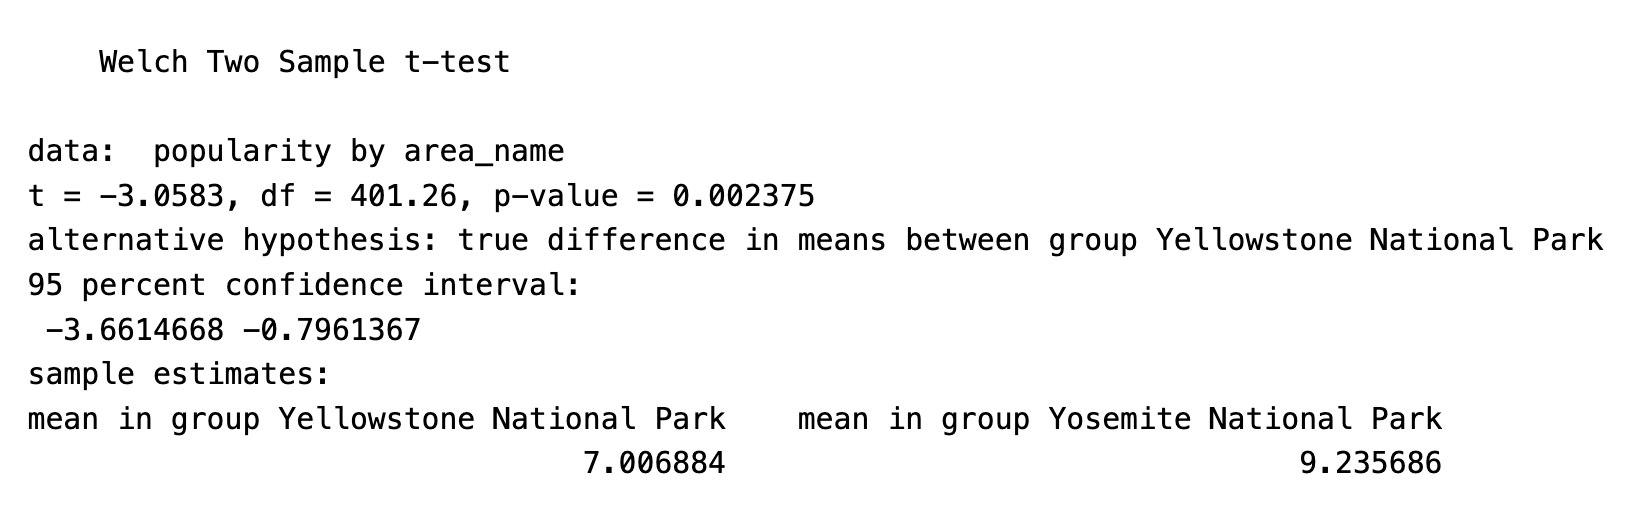
Popularity: significant (p < 0.05)
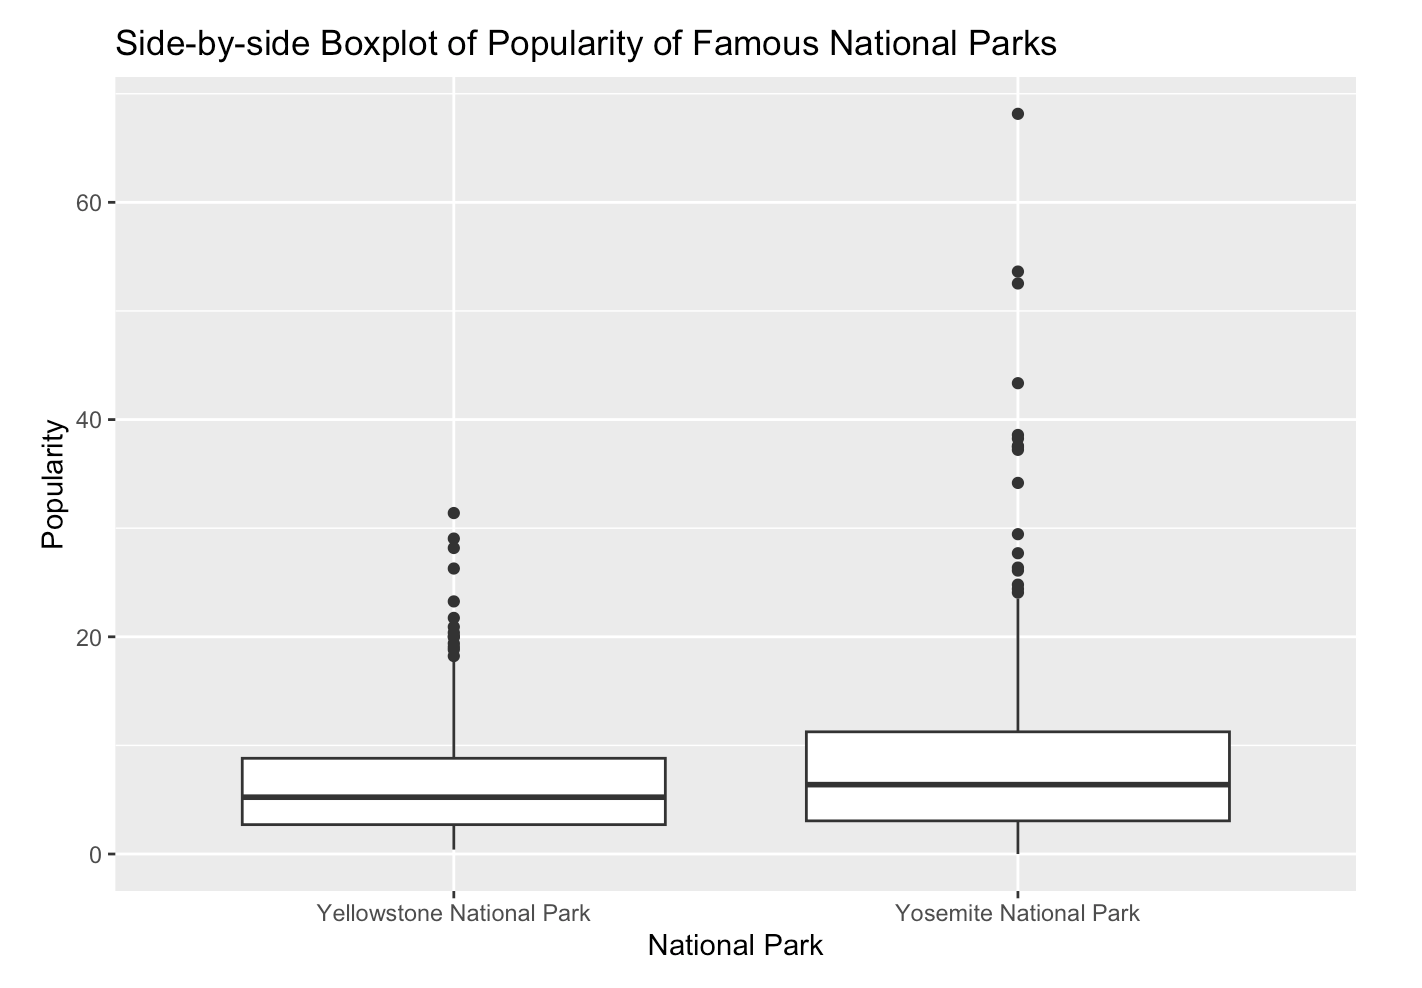
Yosemite's mean popularity (9.235) significantly exceeds Yellowstone's (7.001). Combined with greater trail variety, Yosemite is the better park by this definition.